GPU Clusters: Αρχιτεκτονική και Networking για Large-Scale Training
Η κατασκευή GPU clusters για εκπαίδευση μεγάλων AI μοντέλων απαιτεί τεκμηριωμένες επιλογές σε αρχιτεκτονική, networking και ενεργειακή διαχείριση. Αναλύουμε τις NVIDIA HGX, AMD Instinct, interconnect τεχνολογίες και best practices για αποδοτικότερο system integration σε enterprise περιβάλλον.
- spotlight
- January 6, 2026
- 3:01 pm
- 0 comments

1. Η άνοδος των GPU clusters στην εποχή της παραγωγικής AI
Η εκπαίδευση μεγάλων γλωσσικών μοντέλων (LLMs) απαιτεί υπολογιστική ισχύ που υπερβαίνει κατά πολύ τις δυνατότητες ενός μεμονωμένου συστήματος. Η παγκόσμια αγορά GPU clusters για εκπαίδευση AI αποτιμάται σε 18,2 δισ. δολάρια το 2025 και εκτιμάται ότι θα φτάσει τα 87,5 δισ. δολάρια έως το 2035, με σύνθετο ετήσιο ρυθμό ανάπτυξης (CAGR) 17%. Τα clusters μεγάλης κλίμακας καλύπτουν ήδη το 48,7% της συνολικής ζήτησης, καθώς οι οργανισμοί επιδιώκουν να εκπαιδεύσουν μοντέλα με δισεκατομμύρια παραμέτρους.
Ενδεικτικά, η εκπαίδευση του GPT-4 κατανάλωσε υπολογιστική ισχύ 2,1 × 10²⁵ FLOPs και κόστισε πάνω από 100 εκατ. δολάρια, υπογραμμίζοντας ότι η αποδοτική αρχιτεκτονική cluster δεν είναι «βελτίωση», αλλά προϋπόθεση βιωσιμότητας. Οι πάροχοι cloud συγκεντρώνουν το 62,8% της ζήτησης, καθώς επεκτείνουν τη διαθέσιμη GPU χωρητικότητα για να εξυπηρετήσουν enterprise ανάγκες και AI-native περιπτώσεις χρήσης.
2. NVIDIA HGX: Η κυρίαρχη πλατφόρμα για scale-up αρχιτεκτονικές
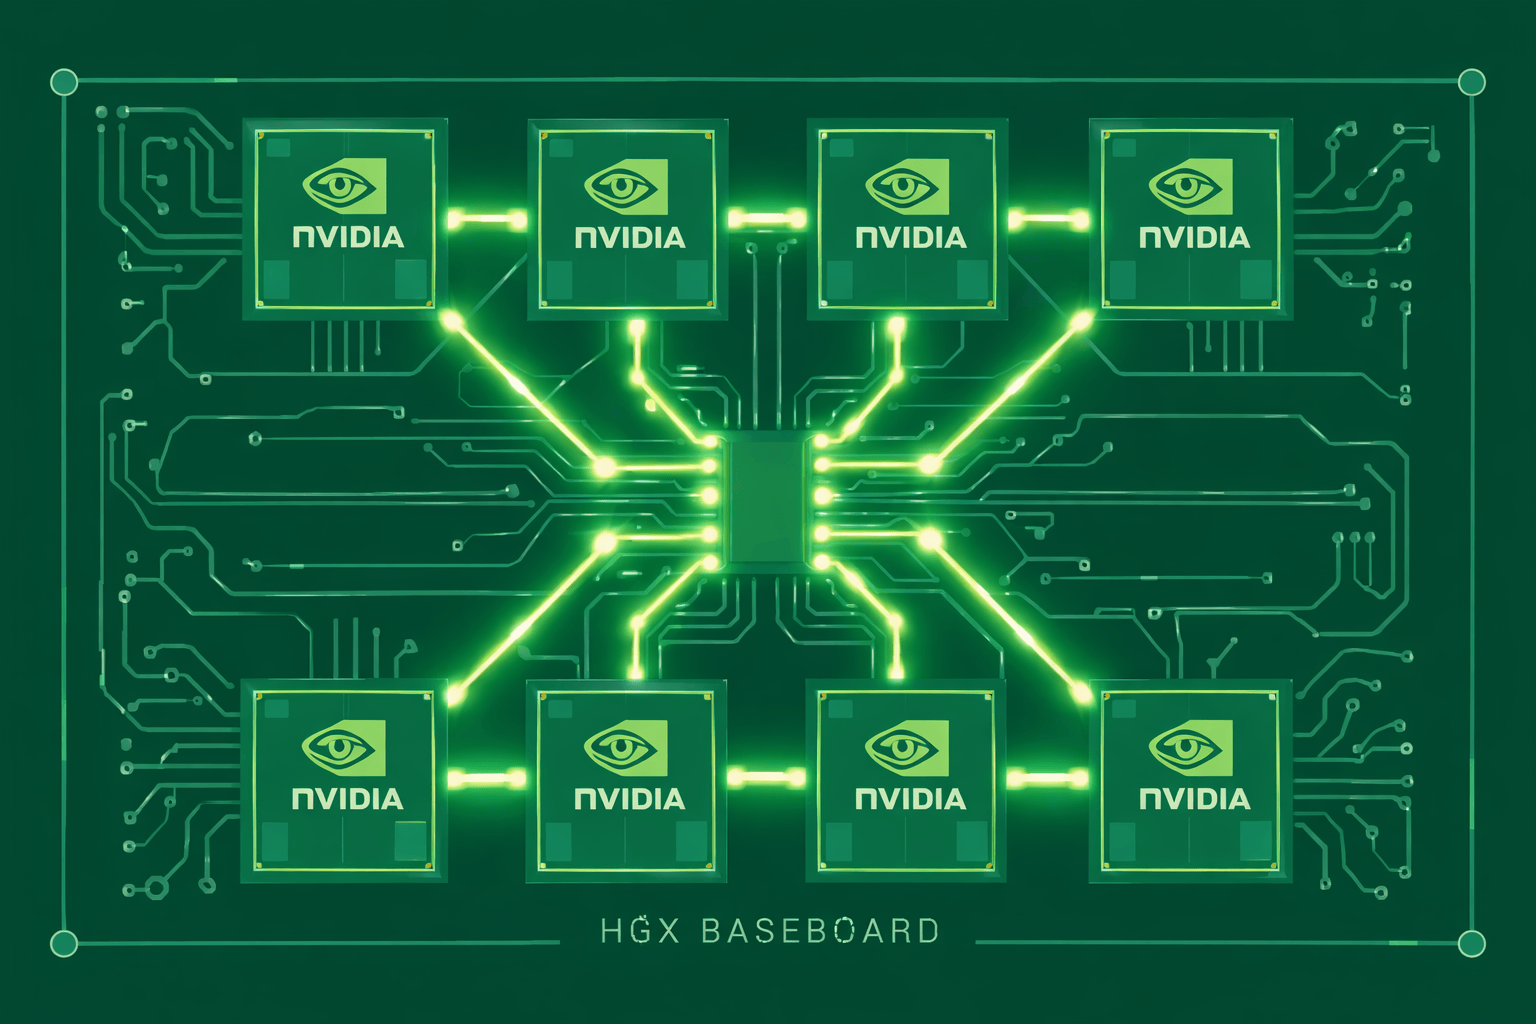
Η πλατφόρμα NVIDIA HGX B300 ενσωματώνει 8 Blackwell Ultra GPUs, με συνολική υπολογιστική ισχύ 72 PFLOPS σε FP8 και συνολική μνήμη 2,1 TB. Η 5ης γενιάς NVLink παρέχει 1,8 TB/s bandwidth μεταξύ GPUs, με συνολικό εύρος ζώνης 14,4 TB/s ανά HGX baseboard, επιτρέποντας πρακτικά άμεση κοινή χρήση δεδομένων/μνήμης με ελάχιστο overhead αντιγραφής.
Σε επίπεδο διασύνδεσης, υποστηρίζονται επιλογές έως 800 Gb/s μέσω NVIDIA Quantum-X800 InfiniBand και Spectrum-X Ethernet. Το HGX B300 αποδίδει έως 11× υψηλότερο inference throughput σε σύγκριση με την προηγούμενη γενιά Hopper για μοντέλα όπως το Llama 3.1 405B. Παράλληλα, η 2ης γενιάς Transformer Engine, με υποστήριξη FP8 και νέων formats, στοχεύει σε έως 4× ταχύτερη εκπαίδευση LLMs, ειδικά όταν ο σωστός συνδυασμός precision και kernel optimizations έχει ενσωματωθεί στην αλυσίδα λογισμικού.
3. AMD Instinct: Εναλλακτική αρχιτεκτονική με έμφαση στη μνήμη
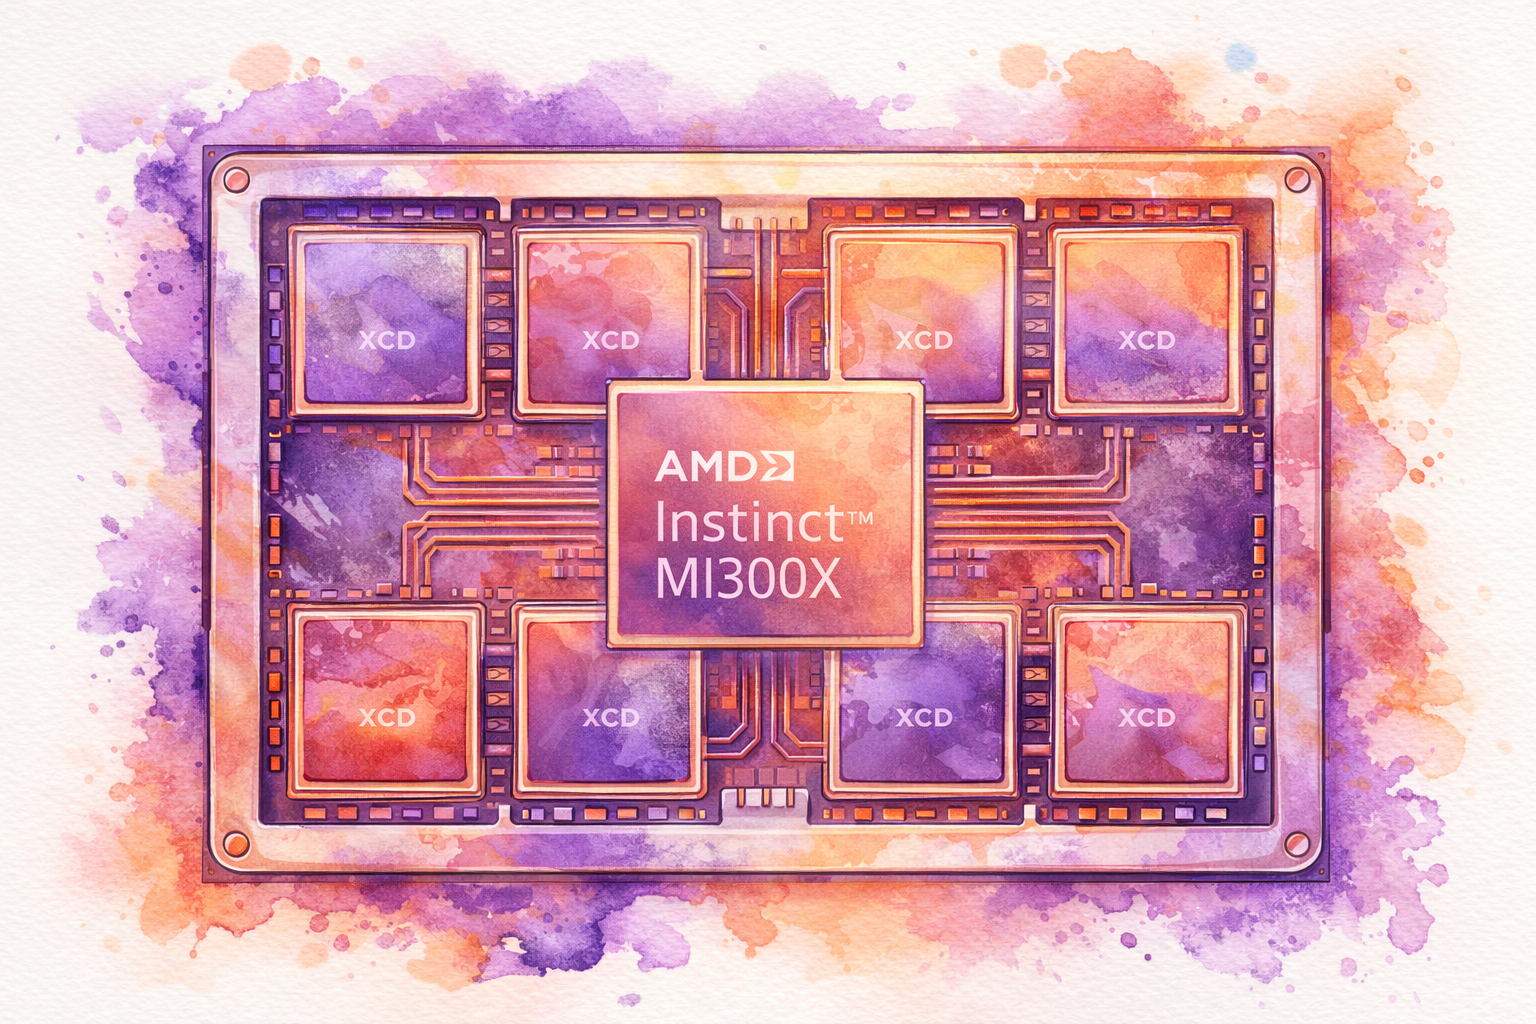
Η AMD προσεγγίζει το πρόβλημα με ισχυρή εστίαση στη χωρητικότητα μνήμης. Η σειρά AMD Instinct MI300X διαθέτει 192 GB HBM3 ανά GPU, με συνολική χωρητικότητα 1,5 TB σε διαμόρφωση 8 accelerators. Η αρχιτεκτονική CDNA 3 αξιοποιεί 8 XCDs (Accelerator Complex Dies) ανά GPU και πλήρως διασυνδεδεμένη Infinity Fabric, ώστε η επικοινωνία μεταξύ accelerators να παραμένει αποδοτική καθώς κλιμακώνεται το workload.
Η νεότερη MI325X ανεβάζει τη μνήμη στα 256 GB και το bandwidth στα 6 TB/s ανά accelerator, με βελτιωμένη ενεργειακή αποδοτικότητα και υποστήριξη matrix sparsity για βελτιστοποίηση training και inference. Με DeepSpeed, ερευνητικές ομάδες έχουν αναφέρει δυνατότητα εκπαίδευσης μοντέλων από 0,3 έως 50 δισ. παραμέτρους σε 64 MI100 GPUs, με αποδοτικότητα 38–44 TFLOPs ανά GPU. Η υψηλή χωρητικότητα μνήμης καθιστά την πλατφόρμα ιδιαίτερα κατάλληλη για workloads με μεγάλα context windows και in-memory datasets.
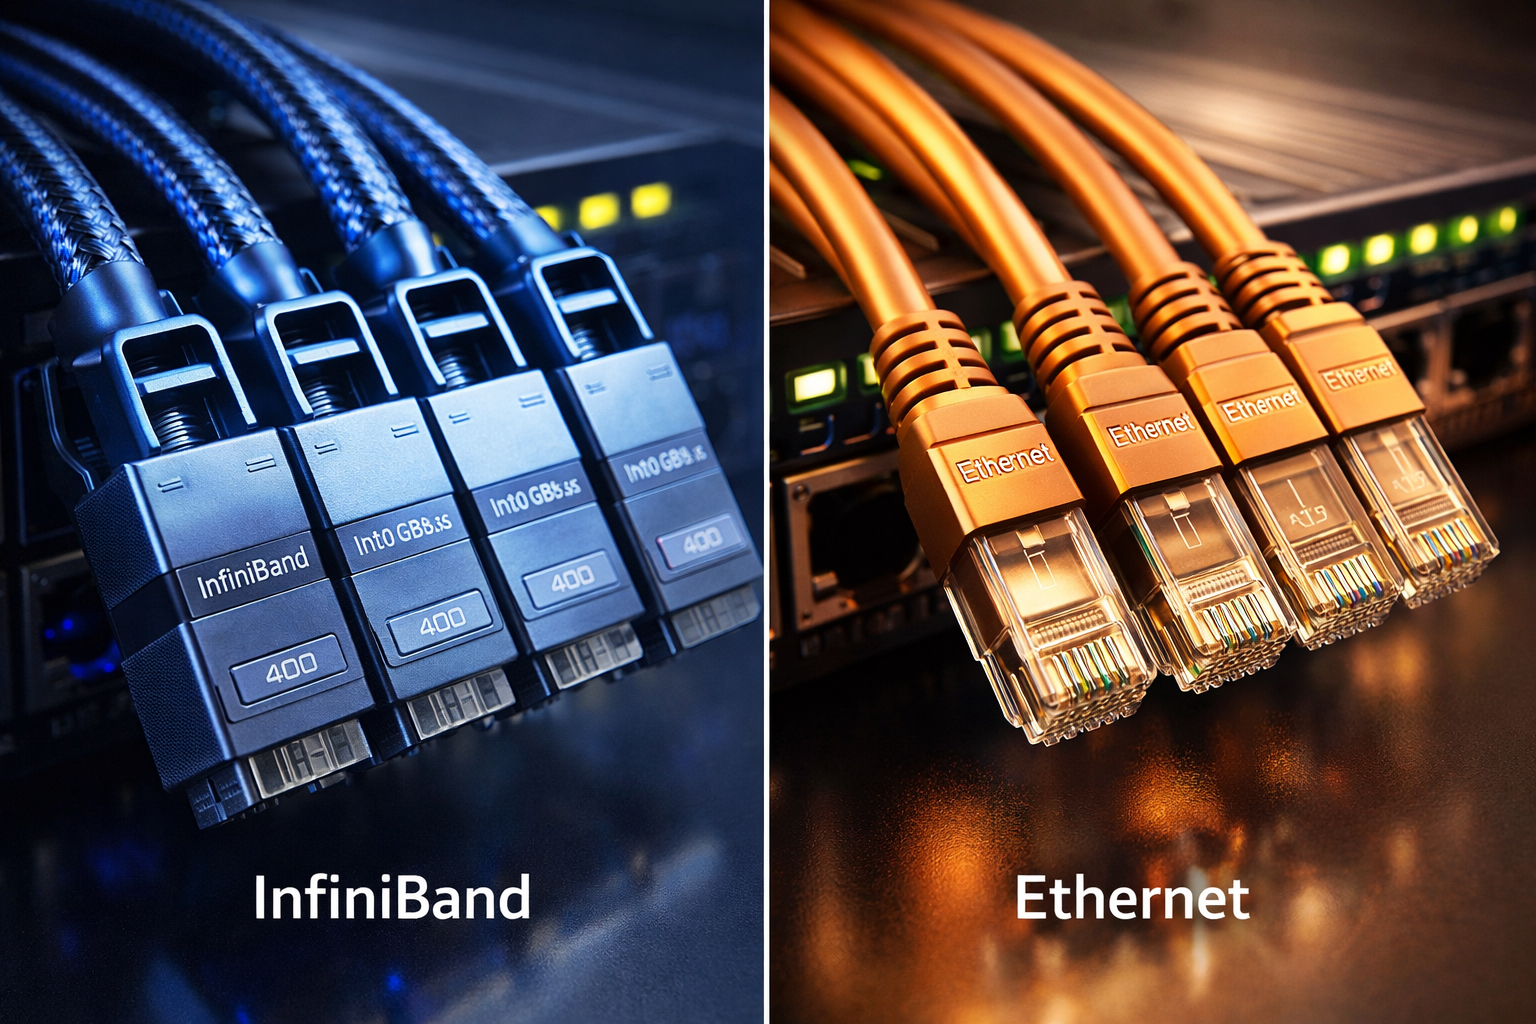
4. InfiniBand vs Ethernet: Κρίσιμες επιλογές διασύνδεσης
Η τεχνολογία interconnect επηρεάζει άμεσα τόσο την απόδοση όσο και το κόστος ενός cluster. Το InfiniBand μπορεί να προσφέρει latency 0,6 μs και αποδοτικότητα εύρους ζώνης 95%, διατηρώντας 190 Gbps πραγματική ταχύτητα σε 200 Gbps θεωρητική χωρητικότητα. Το Ethernet εμφανίζει baseline latency 1,2 μs και αποδοτικότητα 85–92% (ανάλογα με το design), ενώ το RoCE v2 μπορεί να προσεγγίσει την εμπειρία InfiniBand όταν γίνει σωστό tuning.
Για clusters με 32+ κόμβους, το InfiniBand τείνει να προσφέρει καλύτερη κλιμάκωση και πιο προβλέψιμο latency, ενώ το Ethernet παρουσιάζει συγκριτικό πλεονέκτημα κόστους σε μικρότερες εγκαταστάσεις. Σημαντική διαφοροποίηση υπάρχει στη συμπεριφορά υπό συμφόρηση (congestion): το InfiniBand υποβαθμίζεται πιο ομαλά, ενώ το Ethernet μπορεί να εμφανίσει απότομη κατάρρευση απόδοσης υπό incast συνθήκες. Παρά το ότι το InfiniBand κοστίζει περίπου 2,3× περισσότερο, η απόδοση μπορεί να είναι κατά 15% υψηλότερη, κάτι που σε μεγάλης κλίμακας training μεταφράζεται σε ουσιώδη εξοικονόμηση χρόνου και λειτουργικού κόστους.
5. Ενεργειακές και ψυκτικές απαιτήσεις GPU clusters
Τα GPU clusters επιβάλλουν ιδιαίτερα υψηλές απαιτήσεις σε ισχύ και ψύξη. Τα σύγχρονα AI GPUs καταναλώνουν 700 W έως 1.200 W ανά chip, σε συνεχή λειτουργία 24/7. Ένα pod 1.000 NVIDIA H100 GPUs μπορεί να κοστίσει 25–40 εκατ. δολάρια σε hardware και να απαιτεί ενέργεια σε κλίμακα μεγαβατ-ωρών για συνεχή λειτουργία.
Η ψύξη αντιπροσωπεύει συνήθως 35–40% της συνολικής κατανάλωσης σε AI data centers. Οι λύσεις liquid cooling αφαιρούν θερμότητα απευθείας από τα GPUs, ενώ τα συστήματα precision air conditioning ρυθμίζουν τη θερμική συμπεριφορά του χώρου. Σε ορισμένες εγκαταστάσεις εφαρμόζεται immersion cooling, όπου ολόκληροι servers βυθίζονται σε διηλεκτρικά υγρά για μέγιστη απομάκρυνση θερμότητας. Η ενσωμάτωση monitoring με αλγορίθμους machine learning επιτρέπει πρόβλεψη αστοχιών και δυναμική βελτιστοποίηση ενεργειακής χρήσης σε πραγματικό χρόνο.
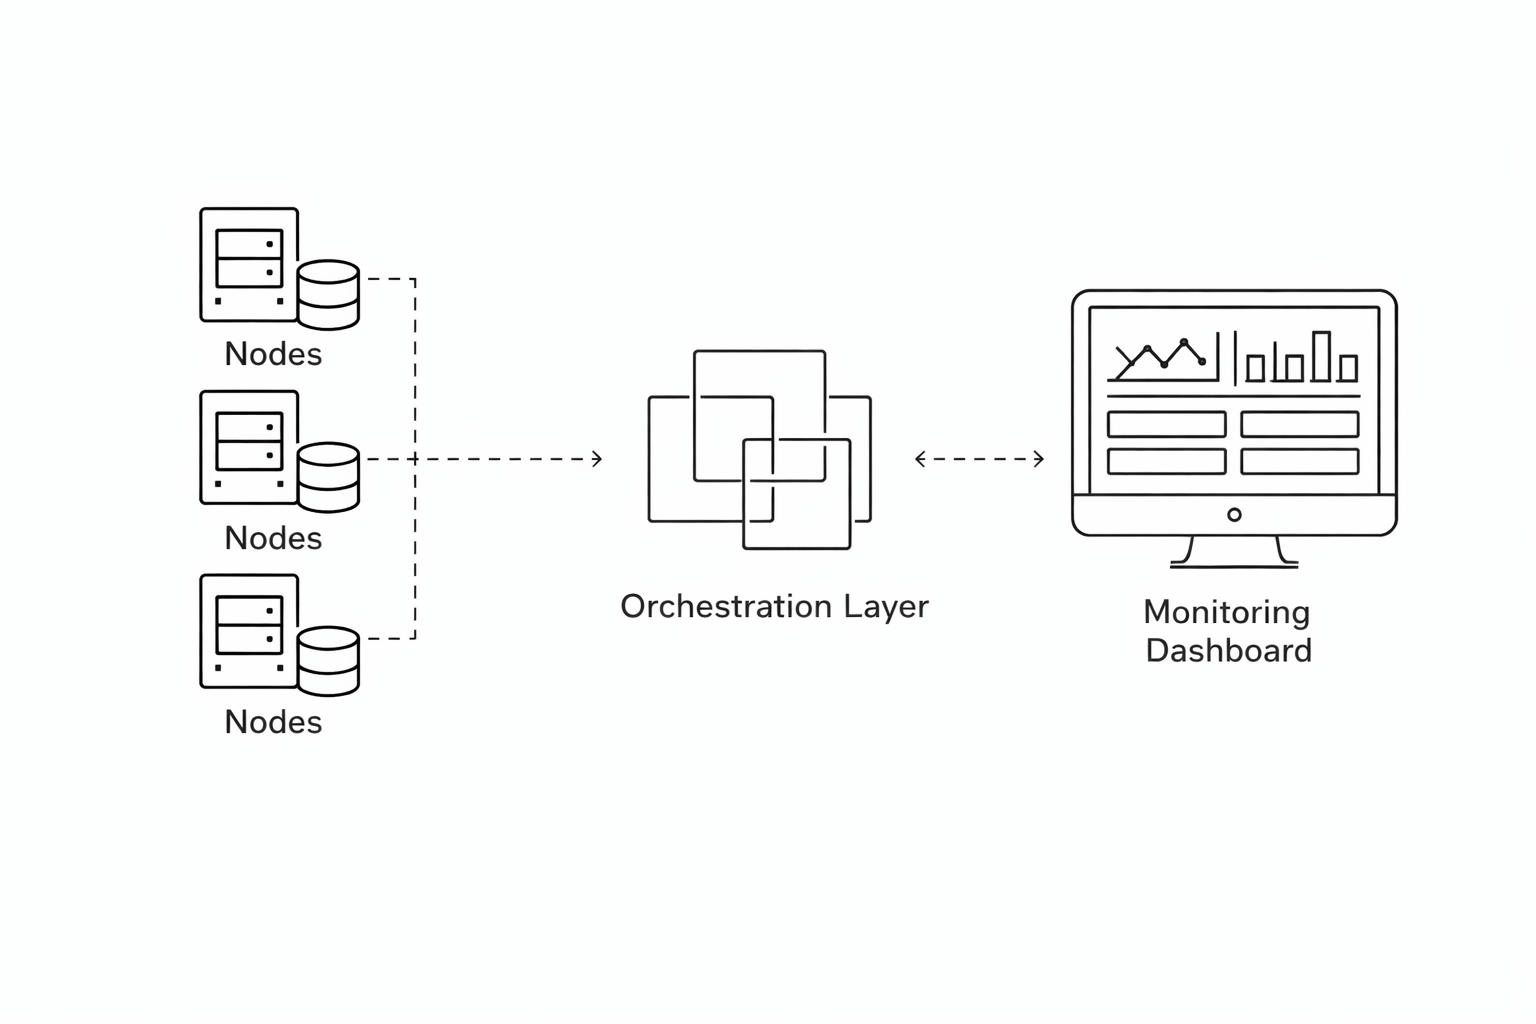
6. Βέλτιστες πρακτικές για system integration και διαχείριση clusters
Η αποδοτική λειτουργία ενός GPU cluster απαιτεί ολιστική μηχανική προσέγγιση. Ο σχεδιασμός του node configuration πρέπει να ισορροπεί GPU density, CPU δυνατότητες, διαθέσιμη RAM και δικτυακή συνδεσιμότητα με βάση τα αναμενόμενα workload patterns. Η επιλογή fabric/interconnect πρέπει να ευθυγραμμίζεται με απαιτήσεις bandwidth, ευαισθησία σε latency και περιορισμούς κόστους.
Οι αλγόριθμοι intelligent workload placement λαμβάνουν υπόψη χαρακτηριστικά hardware, τρέχουσα χρήση, topology του δικτύου και απαιτήσεις του job, ώστε να μεγιστοποιείται η απόδοση και να αποφεύγονται bottlenecks. Παράλληλα, η υλοποίηση αυτοματοποιημένης ανίχνευσης αστοχιών (failure detection) και μηχανισμών ανάκαμψης (recovery) εξασφαλίζει επιχειρησιακή συνέχεια ακόμη και με αποτυχίες κόμβων. Τέλος, η ανάλυση Total Cost of Ownership (TCO) οφείλει να καλύπτει κόστος hardware, λειτουργικά έξοδα, κατανάλωση ενέργειας και απαιτήσεις συντήρησης σε όλο τον κύκλο ζωής του cluster.
7. Στρατηγική προσέγγιση για enterprise deployments
Η υλοποίηση GPU clusters σε enterprise περιβάλλον απαιτεί προσεκτικό σχεδιασμό και σαφή ευθυγράμμιση με επιχειρησιακούς στόχους. Οι οργανισμοί οφείλουν να αξιολογούν τα trade-offs μεταξύ on-premise και cloud deployments, λαμβάνοντας υπόψη data sovereignty, απαιτήσεις latency και προβλεπόμενη αξιοποίηση (utilization). Η υιοθέτηση multi-cloud και hybrid προσεγγίσεων επιτρέπει αξιοποίηση διαφορών κόστους και διαθεσιμότητας χωρητικότητας μεταξύ παρόχων.
Στρατηγικές συνεργασίες με vendors όπως NVIDIA, AMD, Lenovo, IBM και Cisco διευκολύνουν πρόσβαση σε πρόσφατες καινοτομίες και validated reference architectures. Η predictive scaling, με βάση ιστορικά patterns και προγραμματισμένα workloads, βελτιστοποιεί το resource utilization. Επιπλέον, η χρήση spot instances και preemptible πόρων σε κατάλληλα workloads, σε συνδυασμό με on-demand χωρητικότητα για κρίσιμες εφαρμογές, μπορεί να μειώσει σημαντικά το λειτουργικό κόστος. Τέλος, το intelligent power management (dynamic voltage scaling, GPU power limiting) επιτρέπει συστηματική εξισορρόπηση μεταξύ απόδοσης και κατανάλωσης ενέργειας, στοιχείο καθοριστικό για κλιμάκωση με οικονομική βιωσιμότητα.